

GPT-6 Astra сгенерировал продукт, который страшно развивать
Ситуация
Новый проект, абзац с описанием бизнес-идеи, скриншот интерфейса с Behance — и Codex с GPT-6 Astra. Несколько потоков генерации, почти никакого внимания к коду. Приложение работает, новые функции появляются быстро. В какой-то момент хочется только подбадривать: «Давай дальше, железяка, жги в четыре потока».
Потом открываешь исходники.
В плане ещё около 30 бизнес-задач: доработка API, моделей данных, интеграций. А все маршруты API уже собраны в одном контроллере, типы полей приходится искать по нескольким файлам, каталог собирается перебором загруженных из базы записей, периодическая задача запускается прямо из функции инициализации приложения.
Снаружи — работающий продукт. Внутри — код, в котором даже небольшое изменение требует слишком много осторожности. Для команды это легко превращается в ступор: никто не хочет первым трогать конструкцию, последствия правки в которой трудно предсказать.
Диагноз
Один контроллер для всего API
Каталог, аккаунты, подписки, заказы, платежи, заявки, файлы — всё сходится в ApiController. Отдельные сервисы уже есть, но границы ответственности на уровне API почти не выражены: разные области продукта встречаются в одном большом файле.
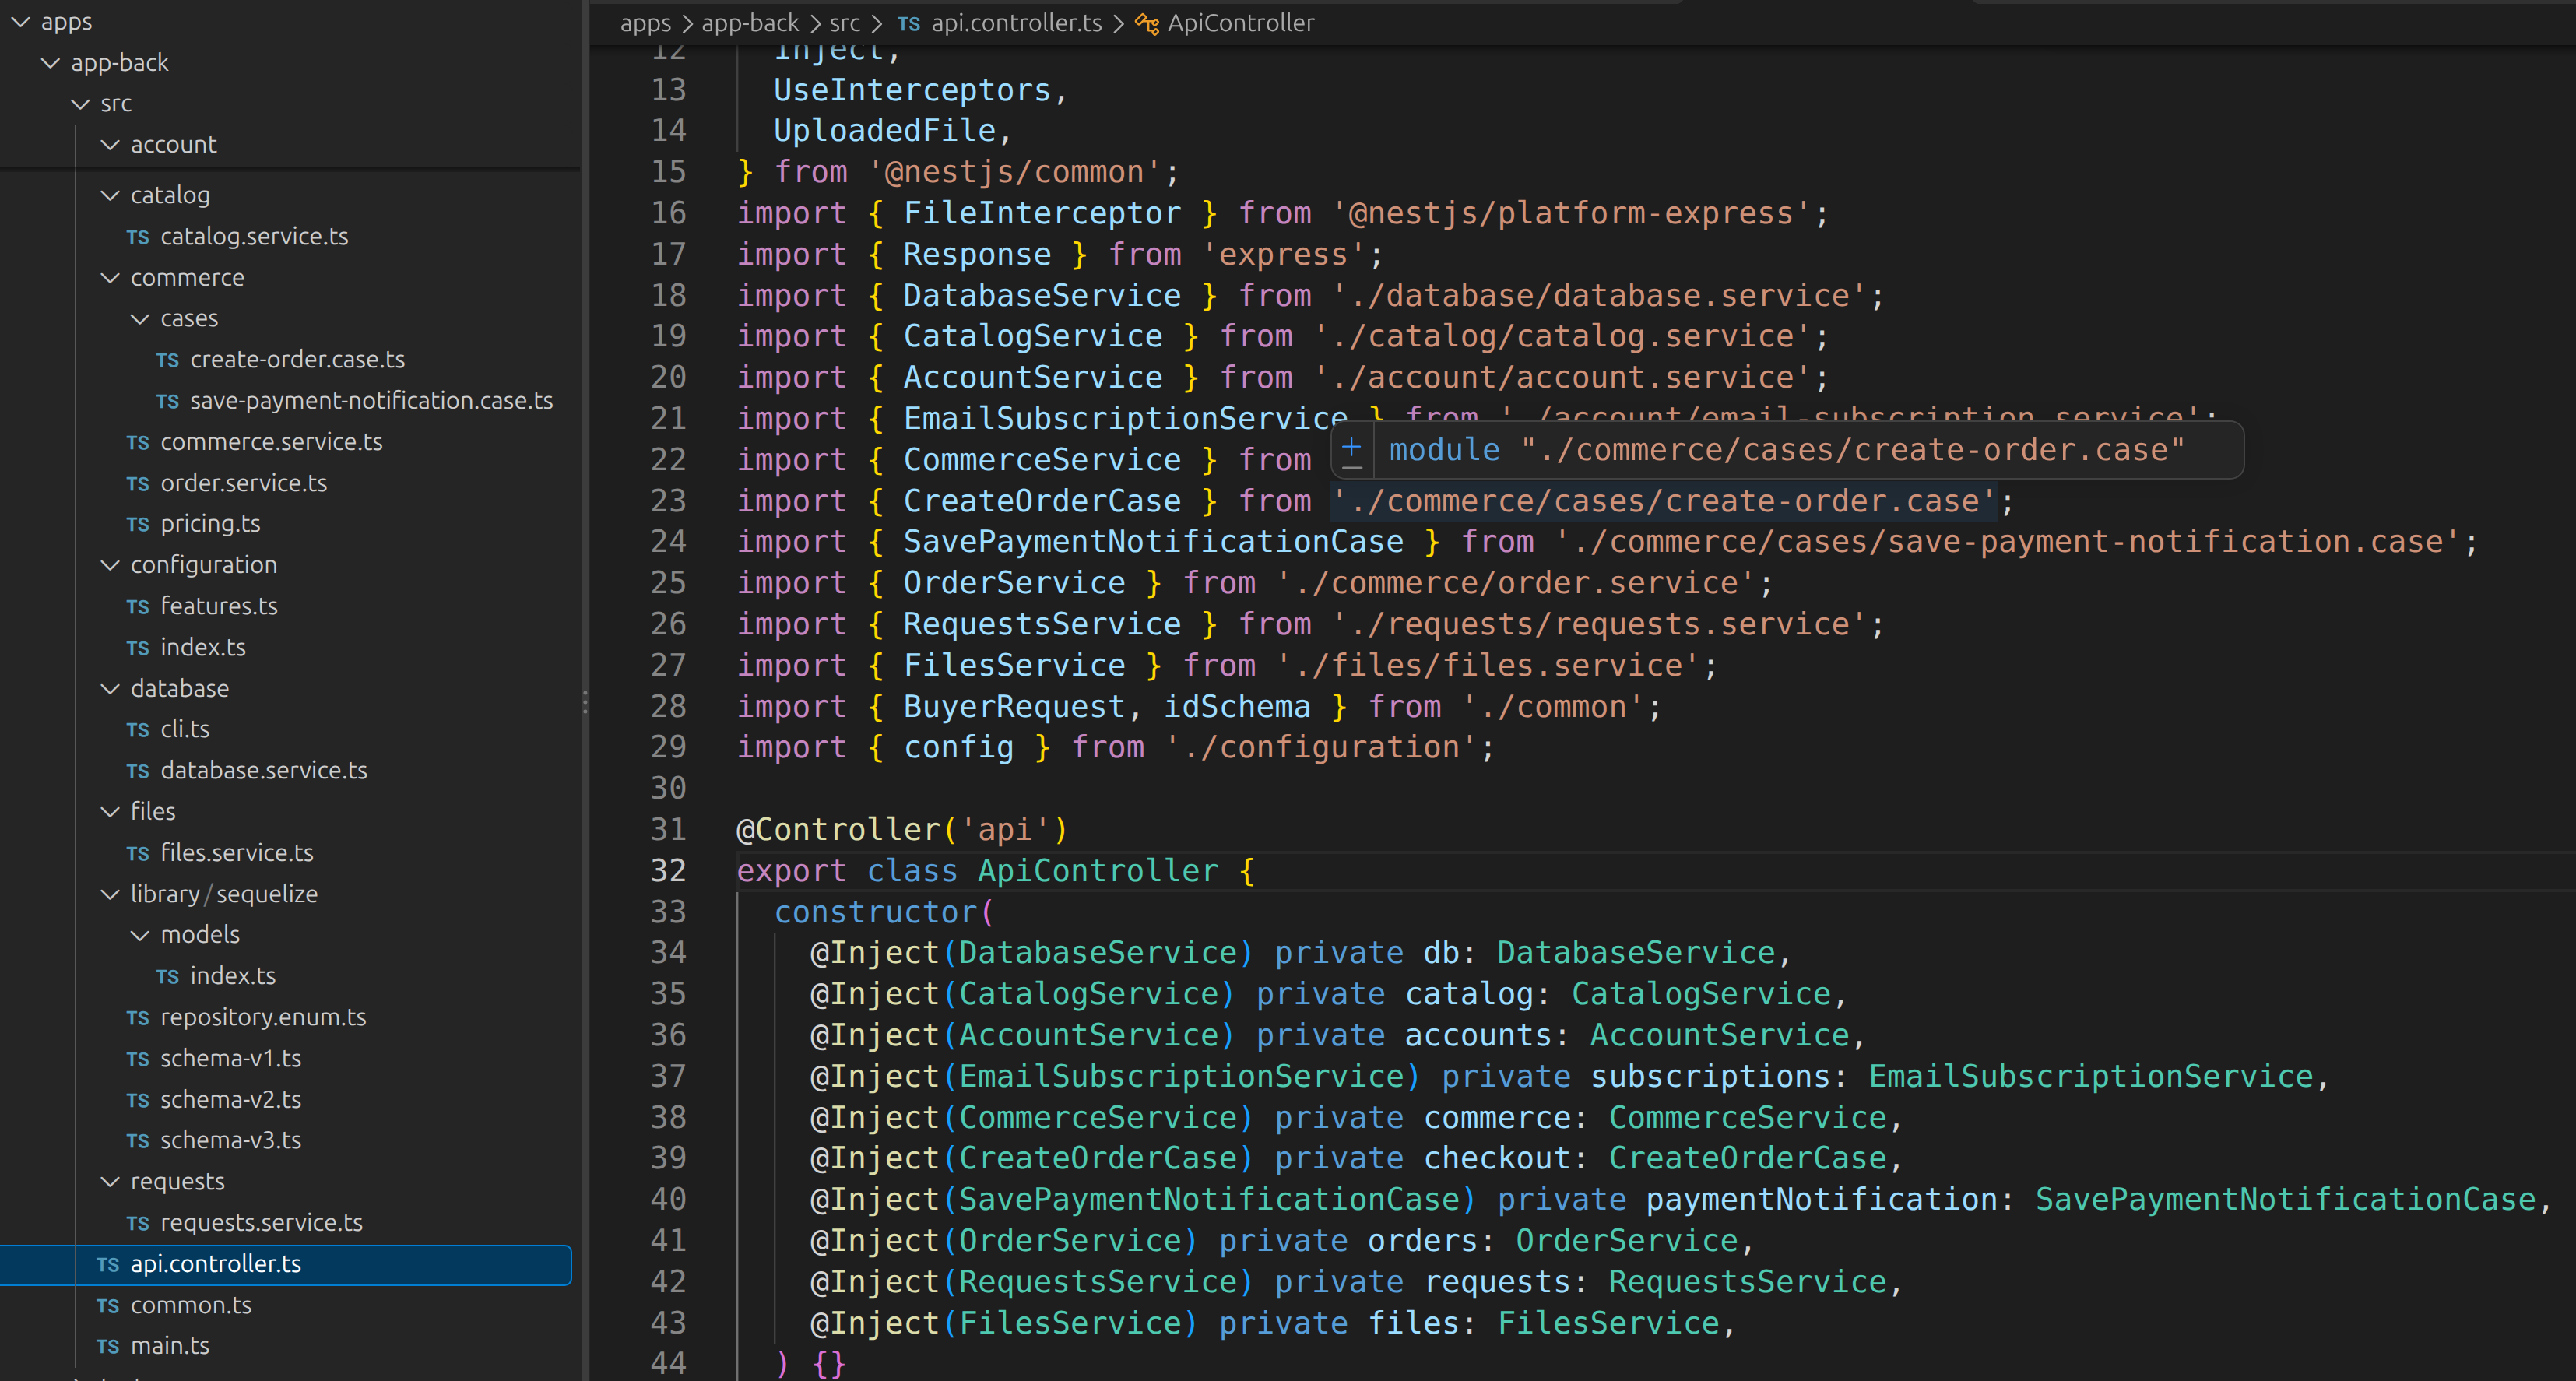
Один контроллер связывает почти все области продукта. Скриншот можно открыть в полном размере.
Есть даже плюс: точку входа любого запроса искать удобно. Открыл один файл — она где-то здесь. Минус проявляется, когда несколько разработчиков начинают одновременно добавлять функции, менять проверки и разбираться, за что отвечает очередной обработчик.
Код на скриншоте я уже немного отформатировал. В исходной версии функции были сжаты в строки, без нормальных переносов и отступов. Форматирование поправить легко. Разделить накопившиеся обязанности — уже отдельная работа.
При таком объёме предстоящих изменений контроллеры стоит разделить по областям продукта, а бизнес-сценарии оставить в сервисах или отдельных обработчиках. Тогда изменение подписки не потребует погружаться в файл, где рядом живут оформление заказа и загрузка изображений.
Модель данных приходится собирать в голове
Текущая схема составляется из schema-v1, schema-v2 и schema-v3, а модели создаются динамически. Результат регистрации описан общим типом Record<string, ModelStatic<Model>>: из него не видно ни конкретных моделей, ни типов их полей.
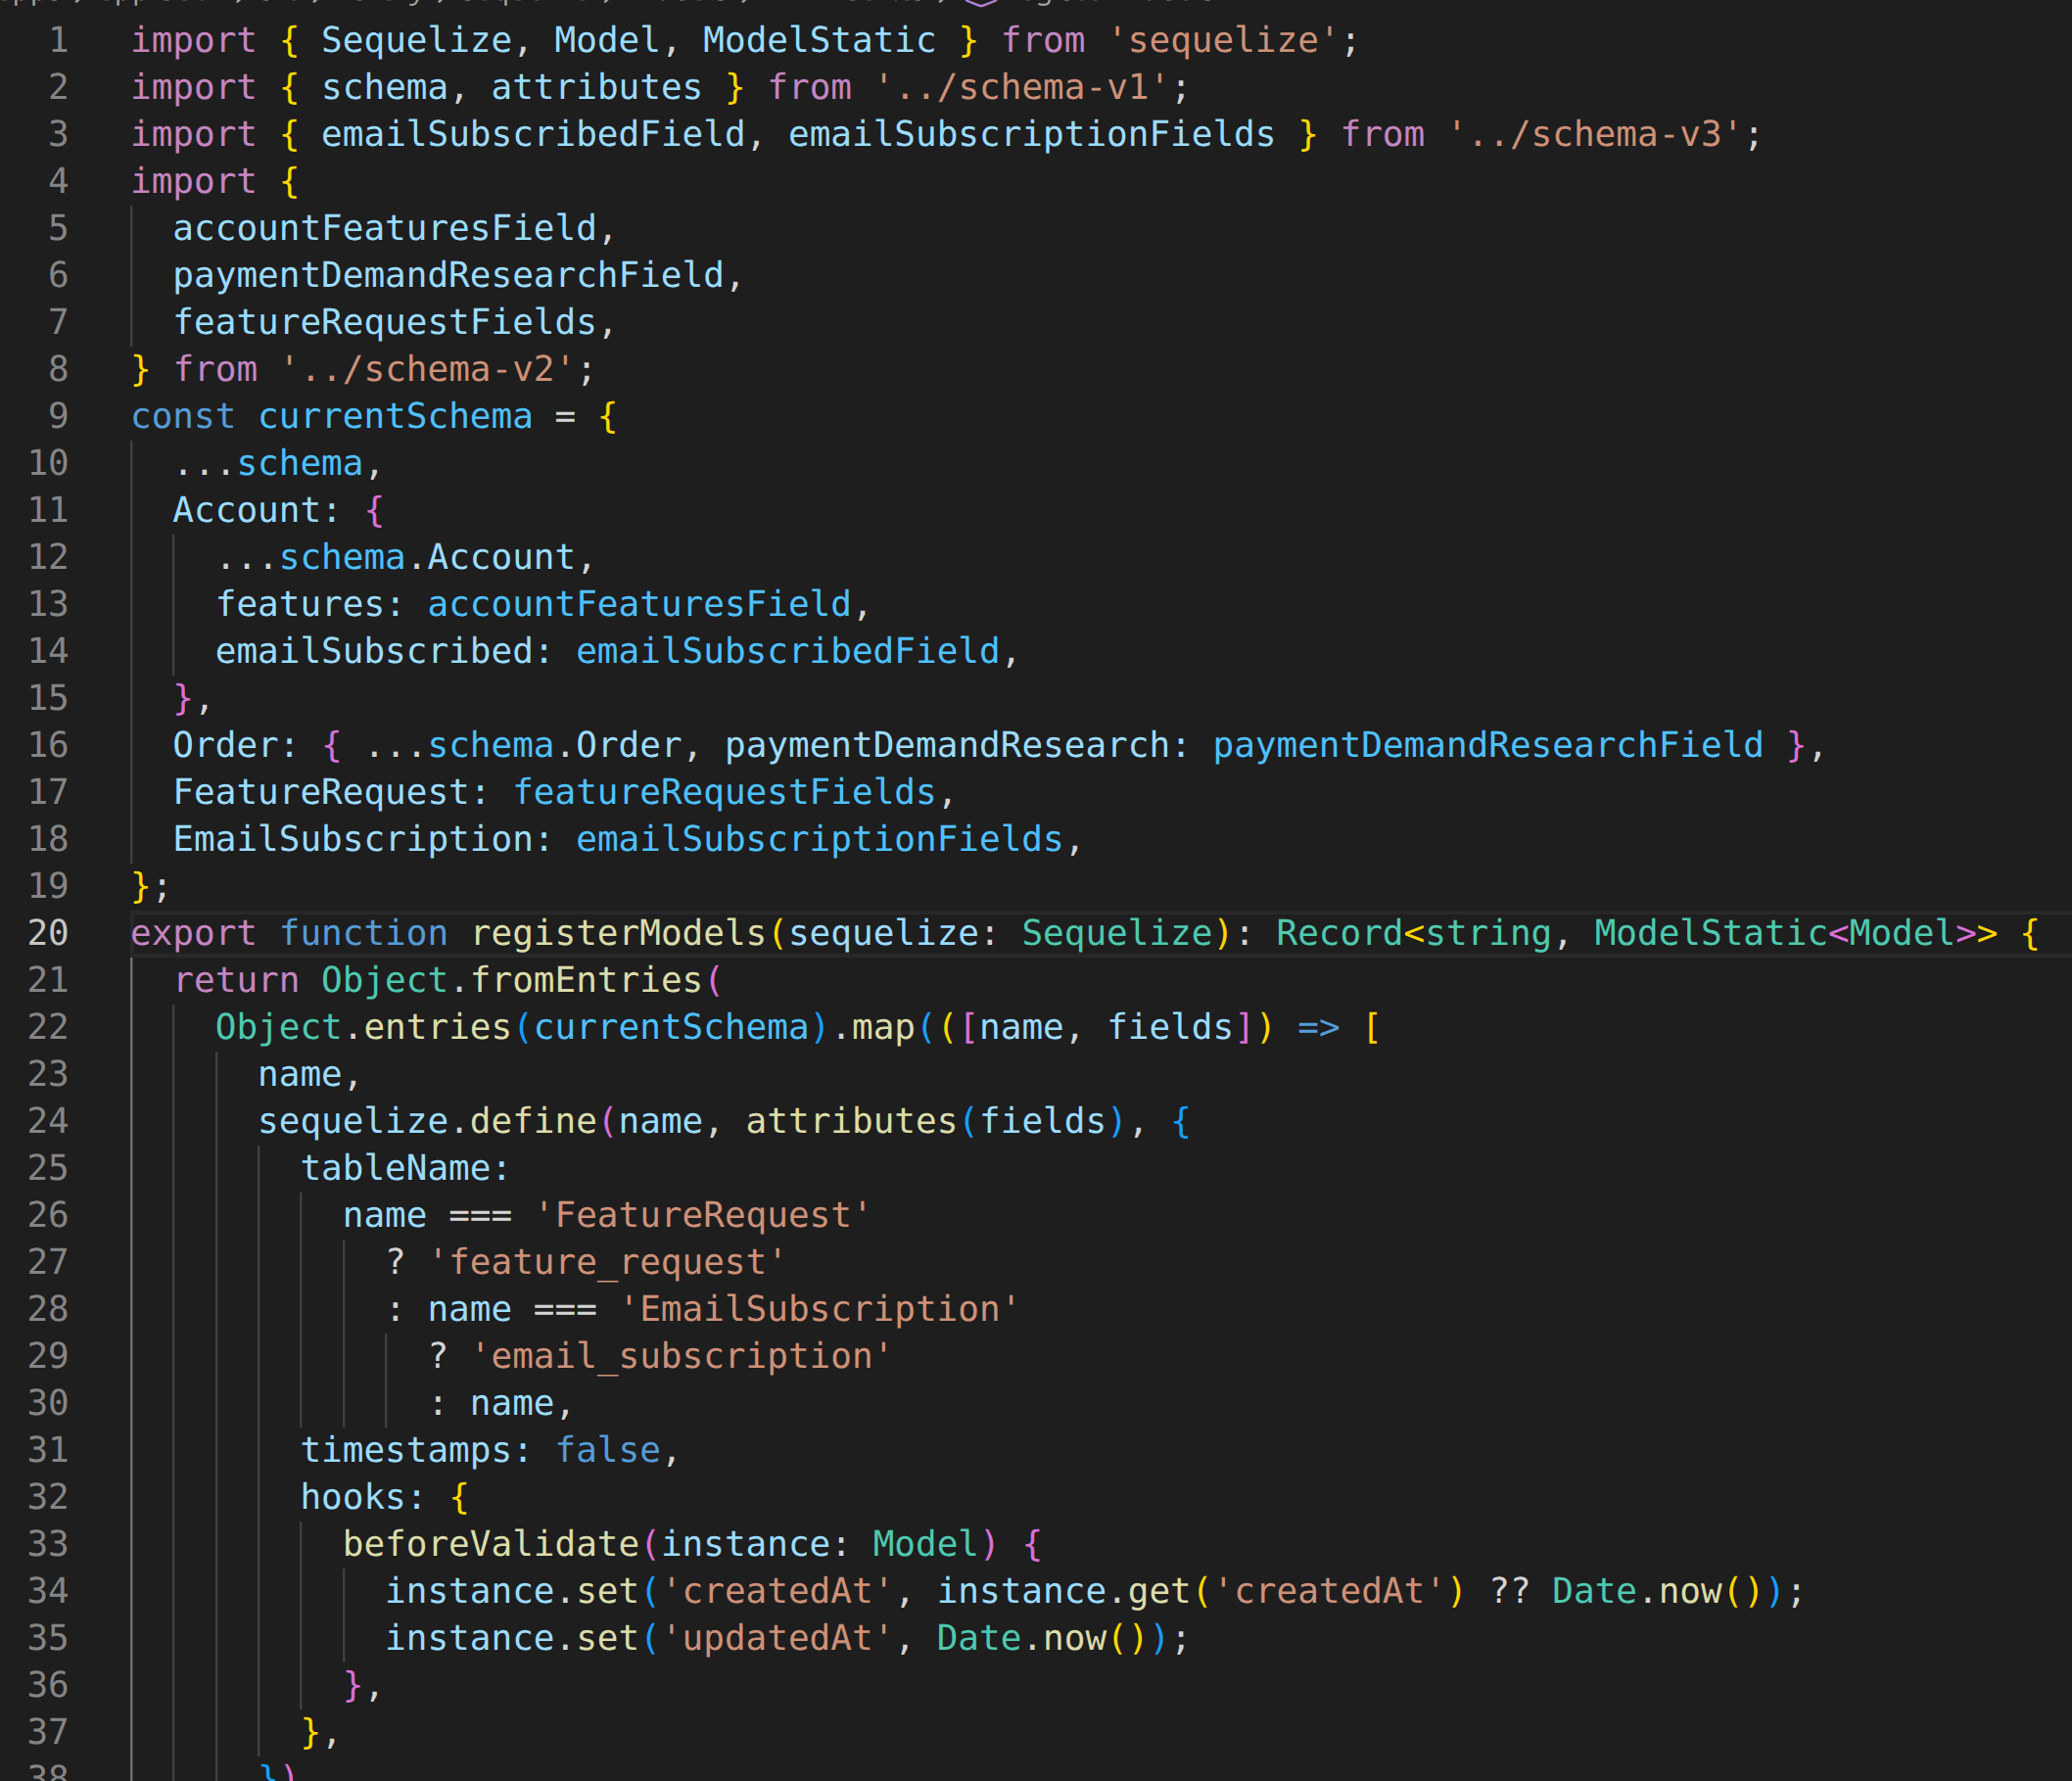
Чтобы понять устройство конкретной модели, приходится пройти цепочку схем и преобразований.
Простой вопрос: какой тип у Product.price? По этому фрагменту ответить нельзя. Переход к определению не привёл меня к нужному описанию — пришлось искать вручную. Выяснилось, что поле целочисленное.
Целое число для цены само по себе нормально: например, так можно хранить сумму в копейках или центах. Другой вариант — DECIMAL с явно заданной точностью и аккуратной обработкой значения в приложении. Выбор зависит от требований к валютам, расчётам и округлению. Здесь проблема в том, что договорённость о представлении денег трудно найти и проверить, а последствия смены типа неочевидны.
Сам вызов sequelize.define тоже не ошибка: Sequelize поддерживает его наряду с объявлением класса модели. Нужны понятные определения сущностей, явные типы и согласованность между базой, API и расчётами. Переписать всё на классы без этих договорённостей недостаточно. См. определение моделей и типизацию Sequelize.
Каталог загружает слишком много данных
Метод products() запрашивает все опубликованные товары и записи из нескольких связанных таблиц. Затем фильтрует товары по группе и собирает ответ в памяти приложения: для каждого товара заново перебирает связи, изображения и модификаторы, ищет определения.
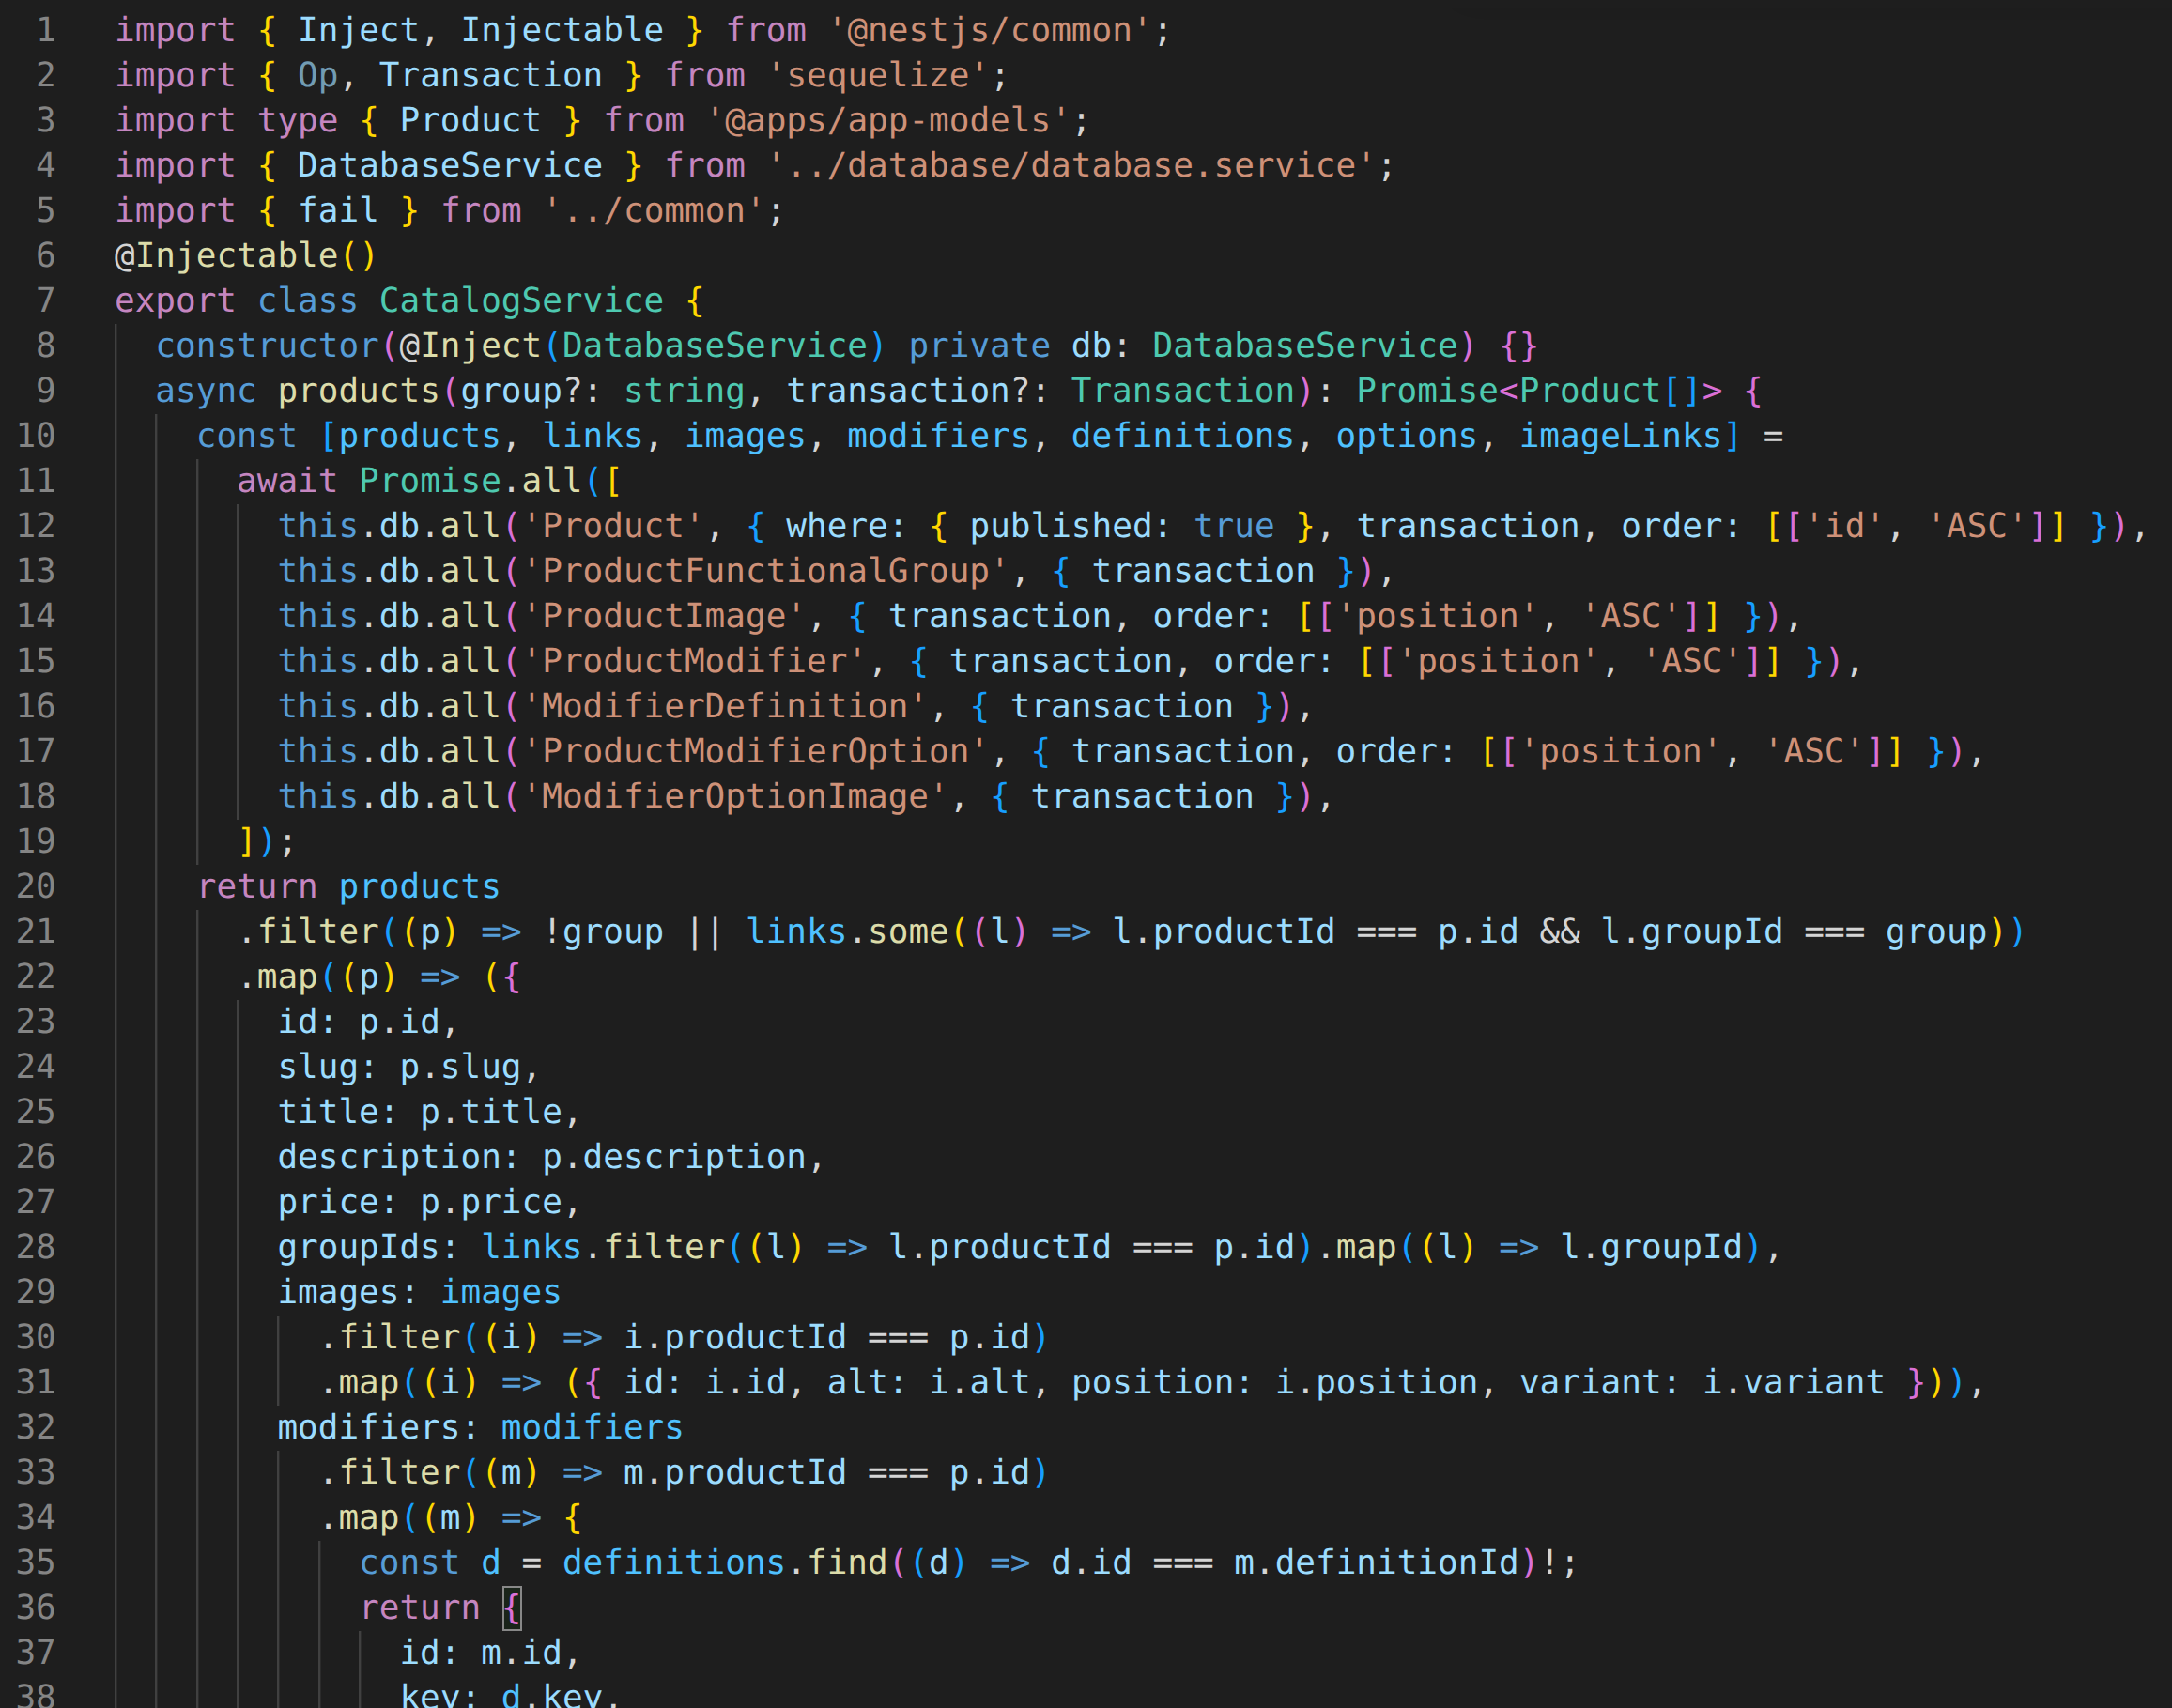
Фильтрация по группе происходит после загрузки данных. Связанные массивы перебираются для каждого товара.
На небольшом каталоге задержка может быть незаметна. С ростом числа товаров и связанных записей увеличиваются объём чтения из базы, расход памяти и работа процессора. Одновременные запросы повторяют эту работу. Пользователь видит только последствие: каталог открывается медленнее, и ждать его становится всё менее интересно.
Объявлять предел в 100 записей или 10 пользователей без нагрузочного теста было бы гаданием. Но причина риска видна уже в коде: стоимость запроса зависит от всего загруженного каталога, даже когда нужна лишь его часть.
Начать стоит с фильтрации в SQL, ограничения выдачи, индексов под реальные запросы и загрузки только нужных связей. Если часть сборки остаётся в памяти, повторные проходы можно заменить заранее построенными словарями по идентификаторам. Кэширование результатов и справочников имеет смысл добавлять после замеров, с понятными правилами обновления кэша.
Периодическая задача спрятана в запуске приложения
В bootstrap находится setInterval с периодом 3 600 000 мс — раз в час. Он удаляет устаревшие записи из buckets, используемого для ограничения частоты запросов, и вызывает FilesService.cleanup().
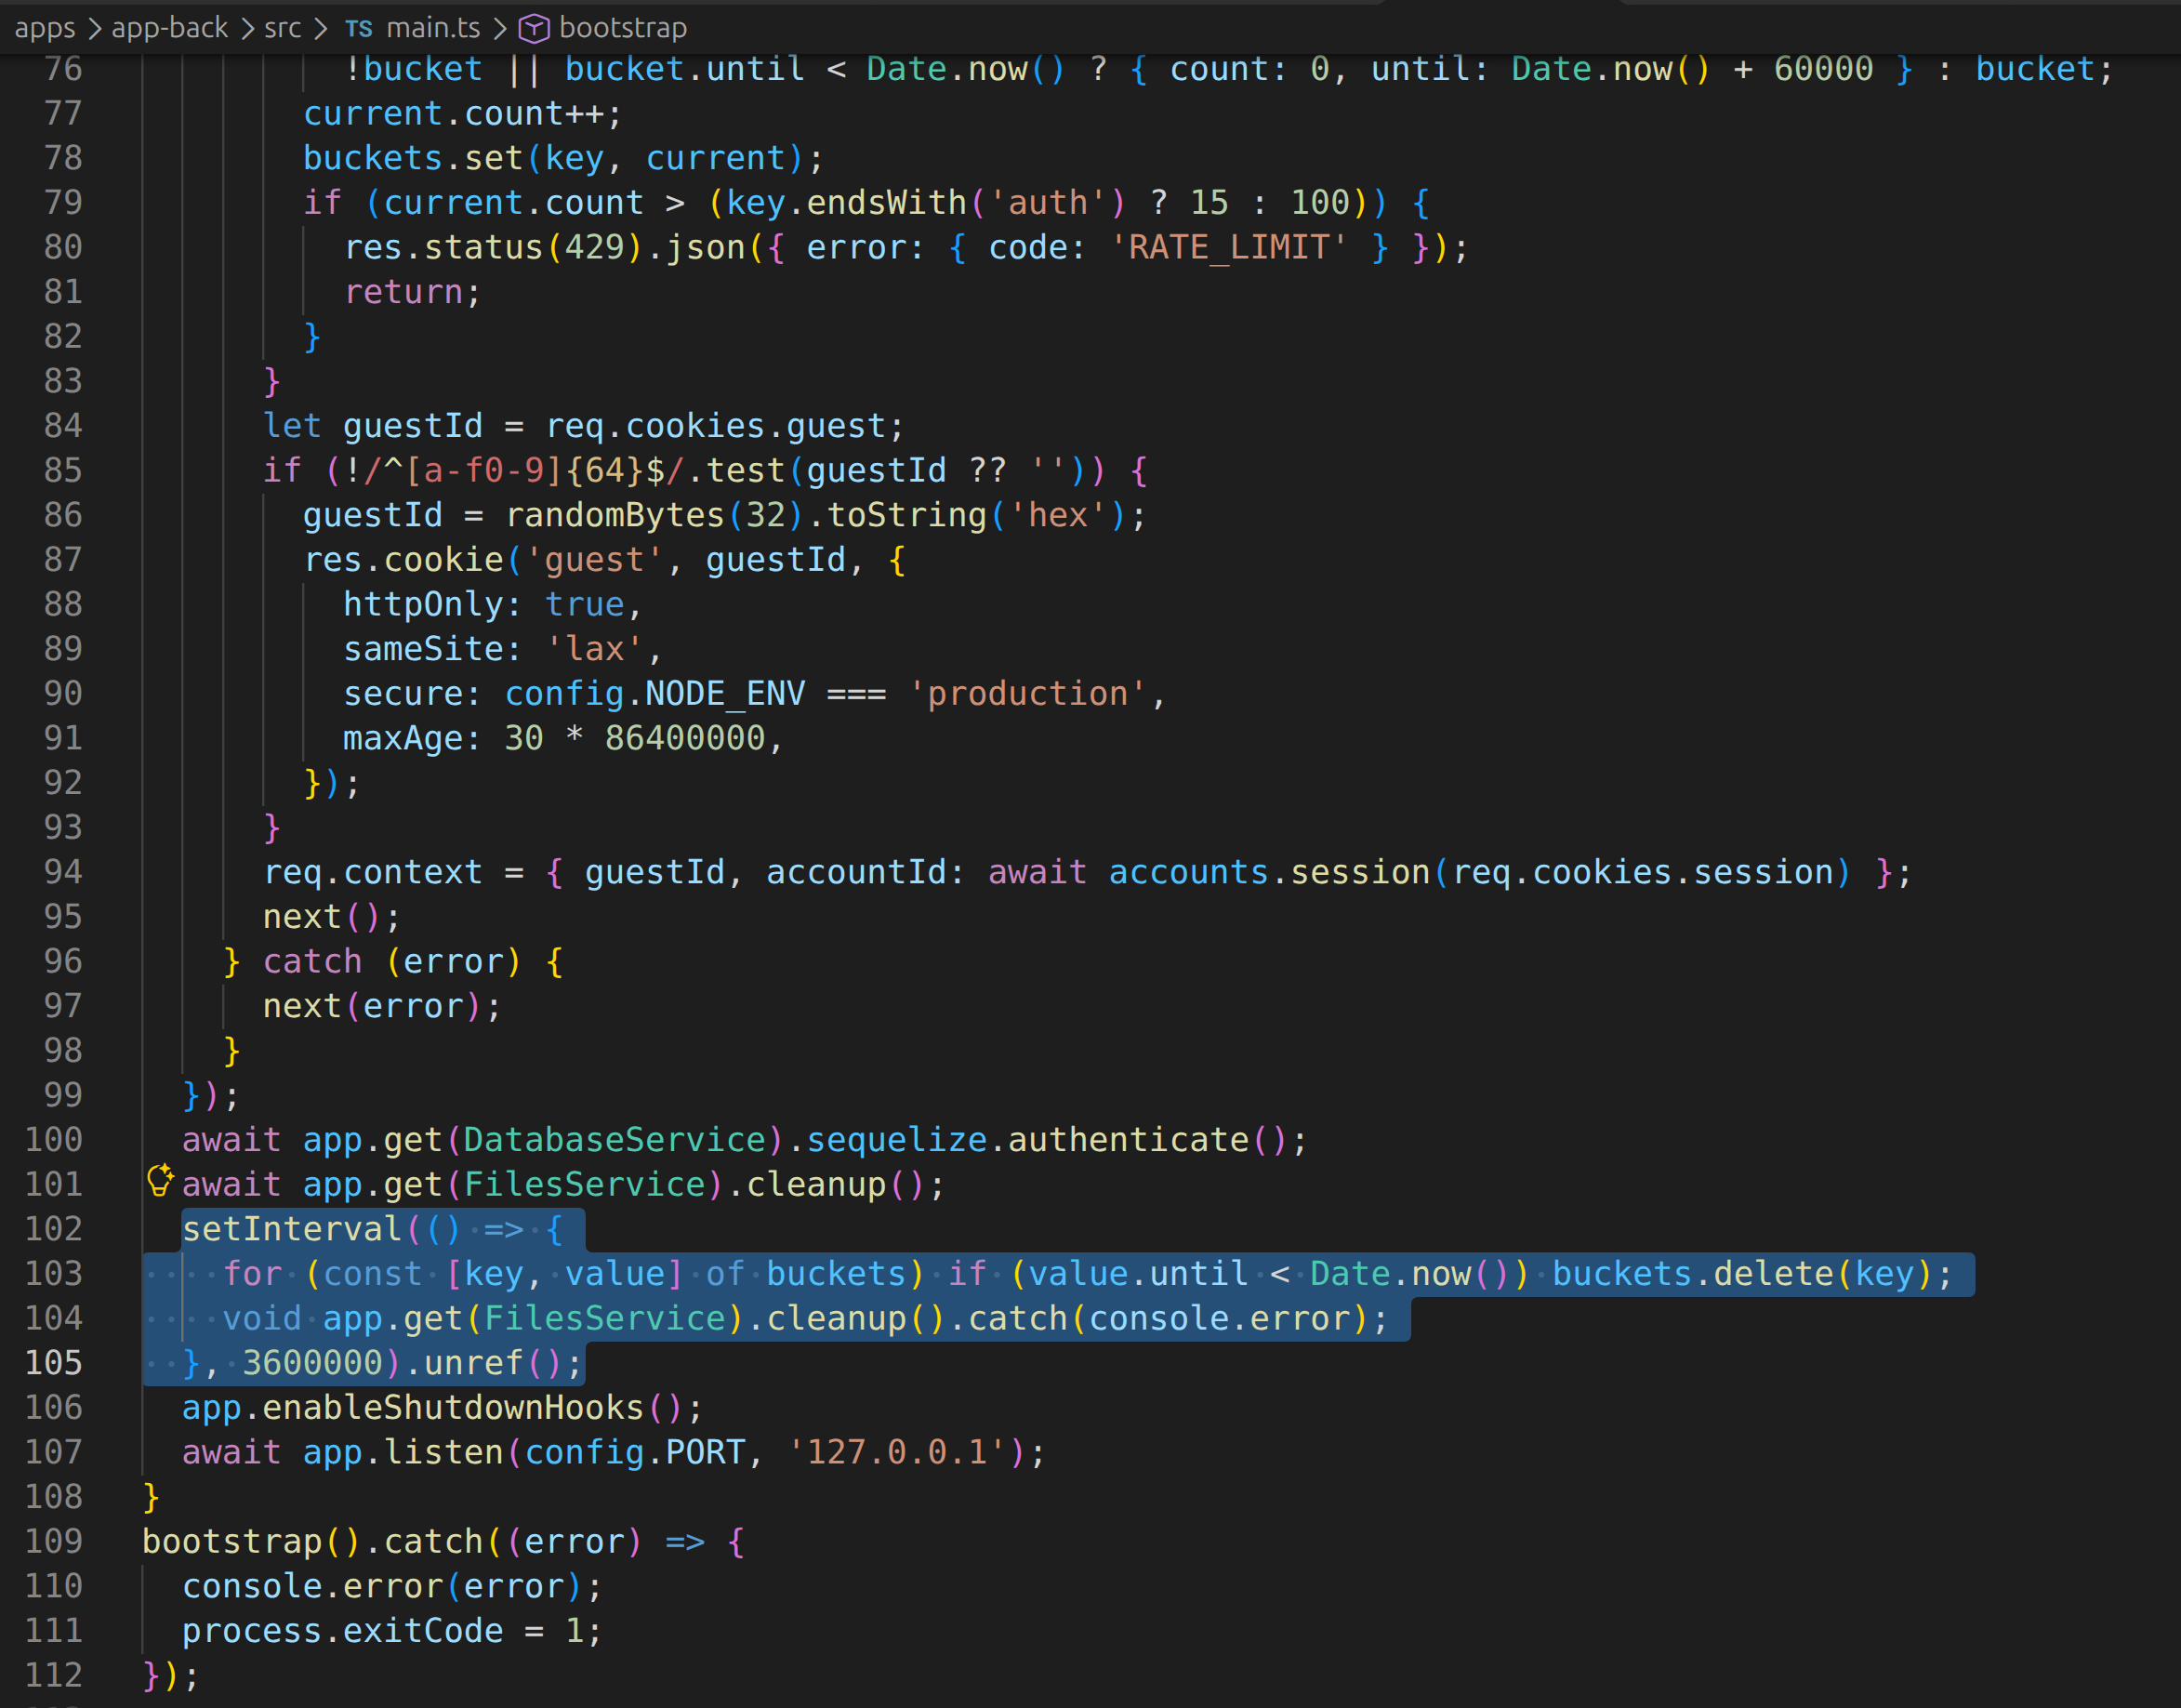
Планирование очистки находится прямо между инициализацией зависимостей и запуском HTTP-сервера.
Сам по себе таймер допустим. Но у фоновой задачи должны быть понятные правила запуска, остановки и обработки ошибок. Здесь ссылка на таймер не сохраняется, а асинхронная очистка запускается без ожидания завершения. Если она затянется дольше интервала, следующий запуск может пересечься с предыдущим. При нескольких экземплярах приложения такой таймер появится в каждом.
Вызов unref() позволяет процессу завершиться, если таймер — единственное, что осталось в цикле событий. Он не отменяет задачу и не организует её корректное завершение. Это следует из документации Node.js о таймерах.
Для NestJS такую задачу удобнее оформить отдельным провайдером с внедрением зависимостей и управляемым расписанием. В модуле планирования NestJS есть интервалы и cron-задачи. Координацию между экземплярами приложения и защиту от повторного выполнения всё равно нужно продумать отдельно.
Что сделал
Разобрал проблемные участки и попросил ту же модель провести ревью: перечислить признаки плохого кода, риски и шаги рефакторинга. Она нашла эти проблемы и составила список. То есть инструмент способен заметить недостатки собственной генерации, если проверка становится отдельной задачей.
У проекта обнаружилась и хорошая опора: около 250 автотестов, созданных во время генерации. Они проверяют основные бизнес-правила. Это не гарантия отсутствия ошибок и не оценка производительности, но полезная страховка для постепенных изменений. Перед рефакторингом стоит проверить, что тесты закрепляют нужное поведение, а не случайные особенности реализации.
Дальше нужен последовательный план доработок:
- Выстроить типизацию. Явно описать сущности, контракты API и представление денежных сумм. Согласовать типы в приложении со схемой базы и миграциями.
- Разделить ответственность. Разнести контроллеры по областям продукта, выделить бизнес-сценарии и вынести периодические задачи из
bootstrap. - Устранить лишнюю работу с данными. Перенести фильтрацию в базу, ограничить выдачу, проверить индексы и повторные проходы по массивам. Измерить время ответа и потребление ресурсов до и после изменений; затем решать вопрос с кэшем.
- Сделать код понятным. Включить единое форматирование и статические проверки. Добавлять комментарии там, где нужно объяснить бизнес-правило или причину решения.
- Зафиксировать правила разработки. Описать кодстайл и архитектурные конвенции. Вести
decisions.mdдля решений и их обоснований,todo.mdдля плана,quality_report.mdдля обнаруженных проблем и статуса исправлений. При работе с таск-трекером связать эти записи с задачами, чтобы статусы не расходились. - Выделить отдельную проверку ИИ-изменений. Настроить субагентов для ревью конвенций, корректности и производительности. Замечания подкреплять примерами и проверками; ответственность за принятие изменений остаётся у команды.
Результат разбора
Теперь есть конкретный список проблем и порядок работы с ними. Рефакторинг ещё предстоит: разбор не ускоряет каталог и не разделяет контроллеры сам по себе. Зато можно исправлять код небольшими шагами, опираясь на тесты и измерения, и понимать, какую проблему решает каждый шаг.
Я проходил все стадии доверия к ИИ — самостоятельно и в командах:
- Сначала просил Copilot объяснить чужой код: «Спасибо, умный друг».
- Потом доверял точечное переписывание: «Ничего не сломалось — уже хорошо».
- Затем поручал модели, сервисы и модули: «Он понял существующий стиль и сделал похоже».
- Позже — интерфейсы и интеграции: «Написал тесты, даже посмотрел результат в браузере».
- И наконец — новый проект с нуля, почти без чтения кода: «Работает. Жги дальше».
Последний этап оказался самым обманчивым. Когда в проекте уже есть хорошие образцы, генерация может их продолжить. При запуске с нуля сами образцы тоже нужно спроектировать и проверить.
Опытный разработчик, использующий ИИ, по-прежнему отвечает за качество результата. Как раньше требовалось ревью коллеги, так теперь нужна проверка сгенерированных изменений — особенно тех, которые затрагивают архитектуру и данные.
Цель этой работы вполне практическая: чтобы команда могла добавлять функции, обсуждать решения и менять код без страха разрушить приложение. ИИ при этом остаётся полезным инструментом. Условия его использования становятся взрослее.
- Было
- Работающий продукт после ИИ-генерации: общий контроллер API, неочевидные типы моделей, тяжёлая выборка каталога и таймер в bootstrap. В плане ещё около 30 бизнес-задач.
- Что сделал
- Разобрал четыре проблемных участка, сопоставил выводы с ревью модели и составил план доработок с опорой на существующие автотесты.
- Результат
- Есть конкретный список рисков и порядок их устранения. Рефакторинг и проверка производительности ещё предстоят.
У вас похожая ситуация?
Давайте проведем бесплатный 15-минутный разбор